Svaki novi razgovor s AI asistentom kreće od nule, a većina onoga što vaša tvrtka zna stoji na mjestima koja asistent nikad ne vidi: u raspravama na Slacku, e-mailovima, bilješkama sa sastanaka, na dijeljenim diskovima i u glavama ljudi koji su bili u prostoriji. LLM wiki rješenje je koje isprobava sve više timova, baza znanja koju umjetna inteligencija piše i održava na temelju vaših dokumenata i odluka, pa svaki novi razgovor kreće od onoga što tvrtka već zna. Istu ćete ideju sresti i pod još dva imena, second brain i AI OS.
Andrej Karpathy opisao je taj obrazac u travnju 2026. u kratkoj javnoj bilješci koju je namjerno ostavio apstraktnom, a otad se ideja iz osobnih eksperimenata preselila u timove unutar tvrtki, dok su Claude, ChatGPT i Gemini svaki na svoj način dobili memoriju, projekte ili skillove koji idu u istom smjeru. Šest mjeseci stvarne upotrebe pokazalo je i gdje pristup funkcionira, a gdje zakazuje, i upravo su te pouke najkorisnije svakome tko odlučuje hoće li ga graditi.
Većini timova treba manje nego što vodiči sugeriraju, a pravo je pitanje tko je vlasnik znanja i kako se ono provjerava, puno prije pitanja u kojoj aplikaciji stoji. U Workspaceu jednu verziju koristimo za izvještaje klijentima, prošle odluke, ugovore i procjene, a opisujemo je niže u tekstu.
Zašto vašem AI asistentu treba second brain
Asistent koji ne vidi znanje vaše tvrtke isporučuje rezultat kakav je mogla dobiti bilo koja tvrtka, a vaši ljudi potom troše vrijeme vraćajući ga prema onome što je tvrtka već znala. Noviji modeli taj problem nisu uklonili, jer modelu nedostaju informacije do kojih nema načina doći.
Trošak ponovnog objašnjavanja
Tim bez zajedničkog konteksta plaća trošak koji nitko ne fakturira: svatko drži privatne promptove različite kvalitete, a najbolje objašnjenje klijenta ili procesa stoji u povijesti razgovora jedne osobe, gdje ga novi kolega nikad neće naći. Kvaliteta rezultata na kraju ovisi o tome tko je upisao zahtjev, a ono što tvrtka zajednički zna u tome ne igra nikakvu ulogu. Vidjeli smo to i u vlastitom timu prije nego što smo išta poduzeli, kad su prve minute svakog zadatka odlazile na objašnjavanje asistentu tko je klijent i kako projekt funkcionira.
Context engineering ili prompt engineering
Prompt engineering, odnosno inženjering prompta, bavi se formulacijom jednog zahtjeva, a context engineering, inženjering konteksta, onime što model već zna u trenutku kad zahtjev stigne: uputama, dokumentima, primjerima i poviješću koji stoje pred njim. Drugi se pojam proširio sredinom 2025., kad su Tobi Lütke, direktor Shopifyja, i Andrej Karpathy ustvrdili da bolje opisuje stvarnu vještinu, a Anthropic ga je kasnije nazvao prirodnim nastavkom inženjeringa prompta, čime prompt postaje jedan dio šireg posla.
Proizvođači su otad automatizirali velik dio mehaničkog posla, pa asistenti pamte stvari između razgovora i sami sažimaju duge razgovore, a Anthropic danas savjetuje da datoteke s uputama budu kraće nego prije godinu dana. Nijedna nadogradnja proizvoda, doduše, ne odlučuje umjesto vas što je znanje vaše tvrtke, koja je verzija cjenika važeća i što ste s klijentom dogovorili prošlog proljeća. LLM wiki je spremište inženjeringa konteksta, mjesto na kojem stoje prave informacije, pa ih nitko ne mora ručno slagati prije svakog zadatka.
Zašto veći kontekstni prozor nije rješenje
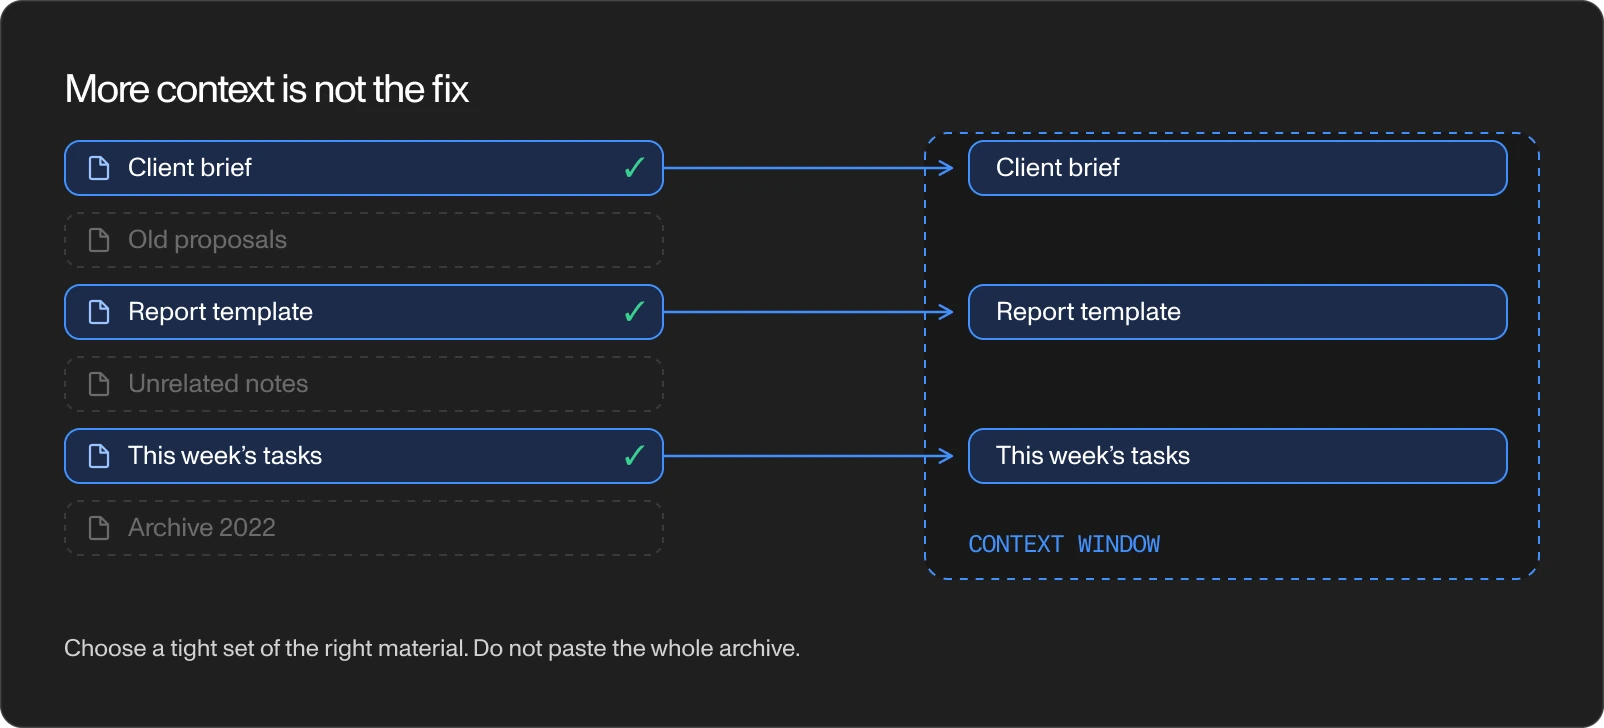
Modeli danas odjednom pročitaju daleko više nego prije godinu dana, dovoljno za cijelu arhivu jednog projekta, pa se lijepljenje svega u razgovor čini kao očit prečac, a on zakazuje iz dvaju razloga. Hrpa dokumenata sa sobom nosi stare verzije i proturječja, model ne može znati koju od njih vaš tim smatra važećom, a i Anthropicova dokumentacija i dalje navodi da više konteksta nije automatski bolje, jer točnost pada kako ulaz raste. Ugrađena memorija zatvara dio te rupe, no ona se veže uz jednu osobu ili jedan projekt, dok tvrtki treba zajednički zapis koji je netko provjerio.
Što je LLM wiki?
LLM wiki je mapa običnih tekstualnih stranica o vašoj tvrtki koje AI model piše i održava na temelju izvora koje mu date. Andrej Karpathy objavio je taj obrazac u travnju 2026. uz jednostavnu podjelu posla, „wiki nikad (ili rijetko) ne pišete sami": vi donosite izvore i postavljate pitanja, a model piše sažetke, povezuje srodne stranice i ažurira ih kad stigne nešto novo.
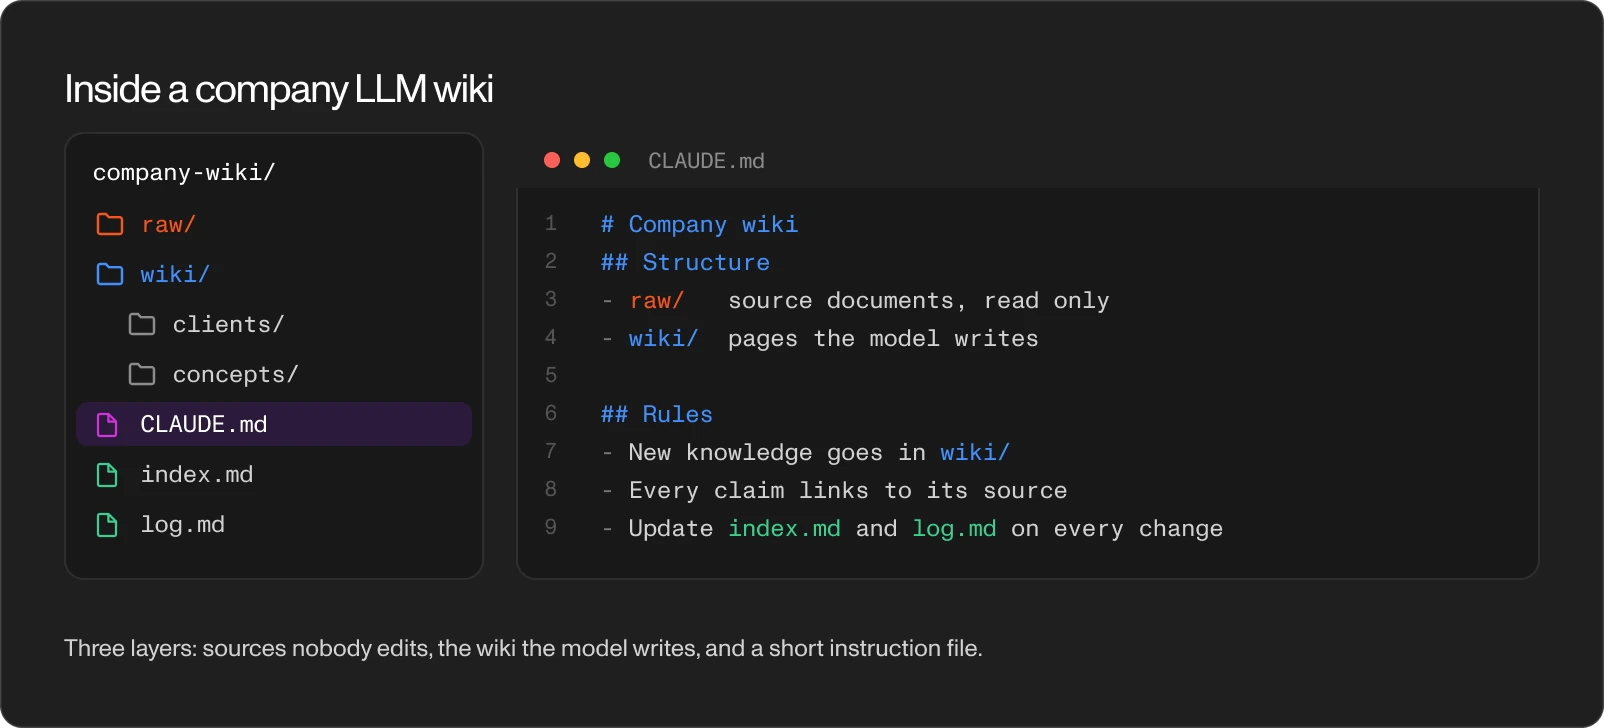
Izvorni materijali (dokumenti, transkripti, ugovori) prvi su od triju slojeva: nitko ih ne uređuje i oni ostaju mjerodavni. Drugi je sloj sam wiki, u kojem model piše sažetak svakog izvora i po jednu stranicu za svakog klijenta, projekt ili temu koja se ponavlja te ih sve međusobno povezuje, a treći je kratka datoteka s uputama, primjerice CLAUDE.md, koja modelu govori kako je mapa organizirana i koja pravila vrijede. Dvije male datoteke drže cjelinu čitljivom i ljudima i modelu, indeks koji popisuje svaku stranicu i dnevnik koji bilježi svaku promjenu.
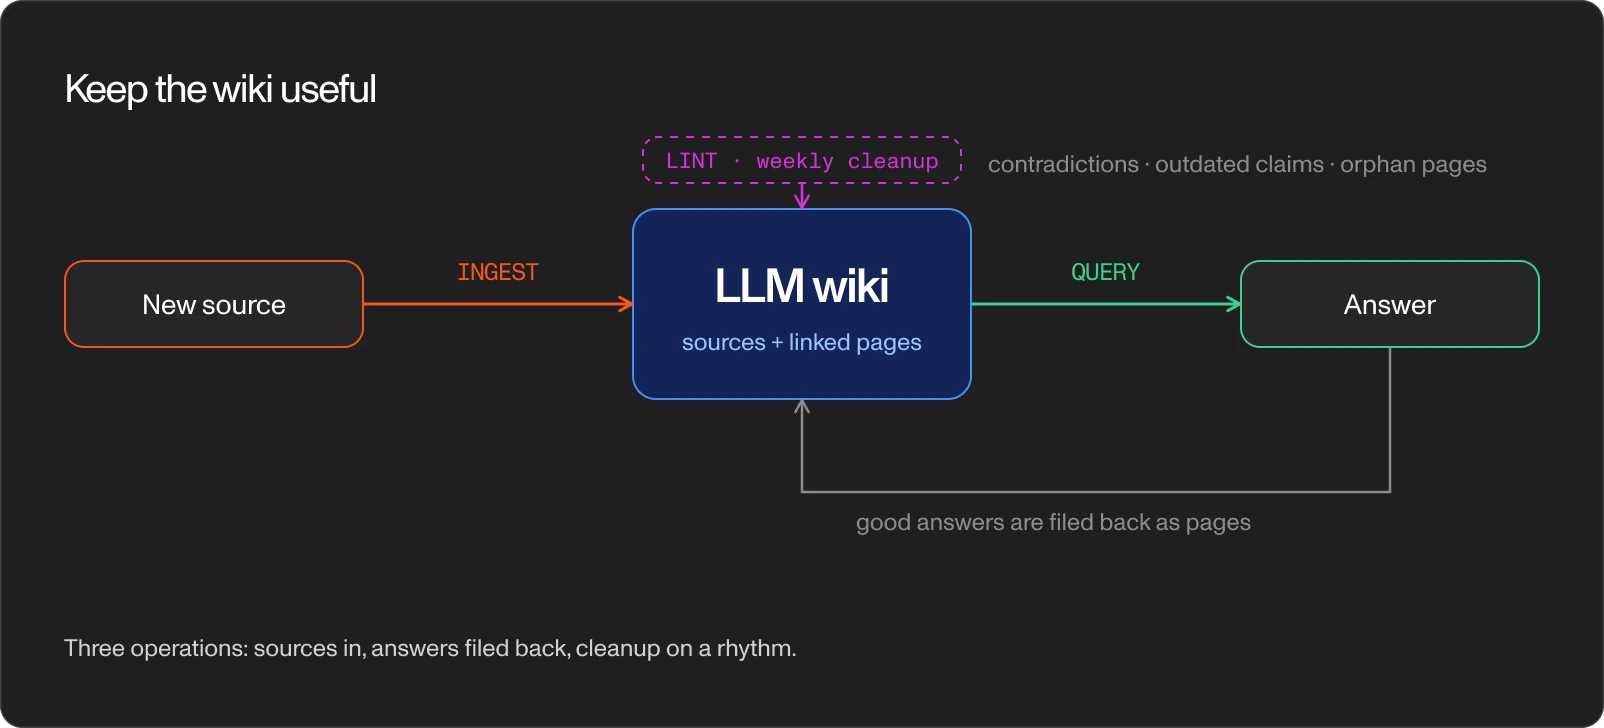
Wiki na životu drže tri operacije, a svaka je običan zahtjev asistentu, izrečen svakodnevnim jezikom. Unos (ingest) znači da model pročita novi izvor i ažurira svaku stranicu na koju taj izvor utječe, upit (query) da na pitanje odgovori iz wikija i dobar odgovor spremi kao novu stranicu, a provjera (lint) redovito je čišćenje proturječja, zastarjelih tvrdnji i stranica na koje ništa ne pokazuje.
Od pretrage po hrpi datoteka ovaj pristup dijeli ono što ostaje: pretraga razumijevanje gradi od nule sa svakim pitanjem, dok wiki zadržava sintezu, što Karpathy naziva trajnim artefaktom čija se vrijednost s vremenom gomila. Time nestaje i razlog zbog kojeg wikiji u tvrtkama obično odumru, a to je održavanje za koje nitko nema vremena, jer model povezivanje i ažuriranje obavi u jednom prolazu, a ljudi u timu s pisanja stranica prelaze na njihovu provjeru.
LLM wiki, second brain, AI OS: je li to ista stvar?
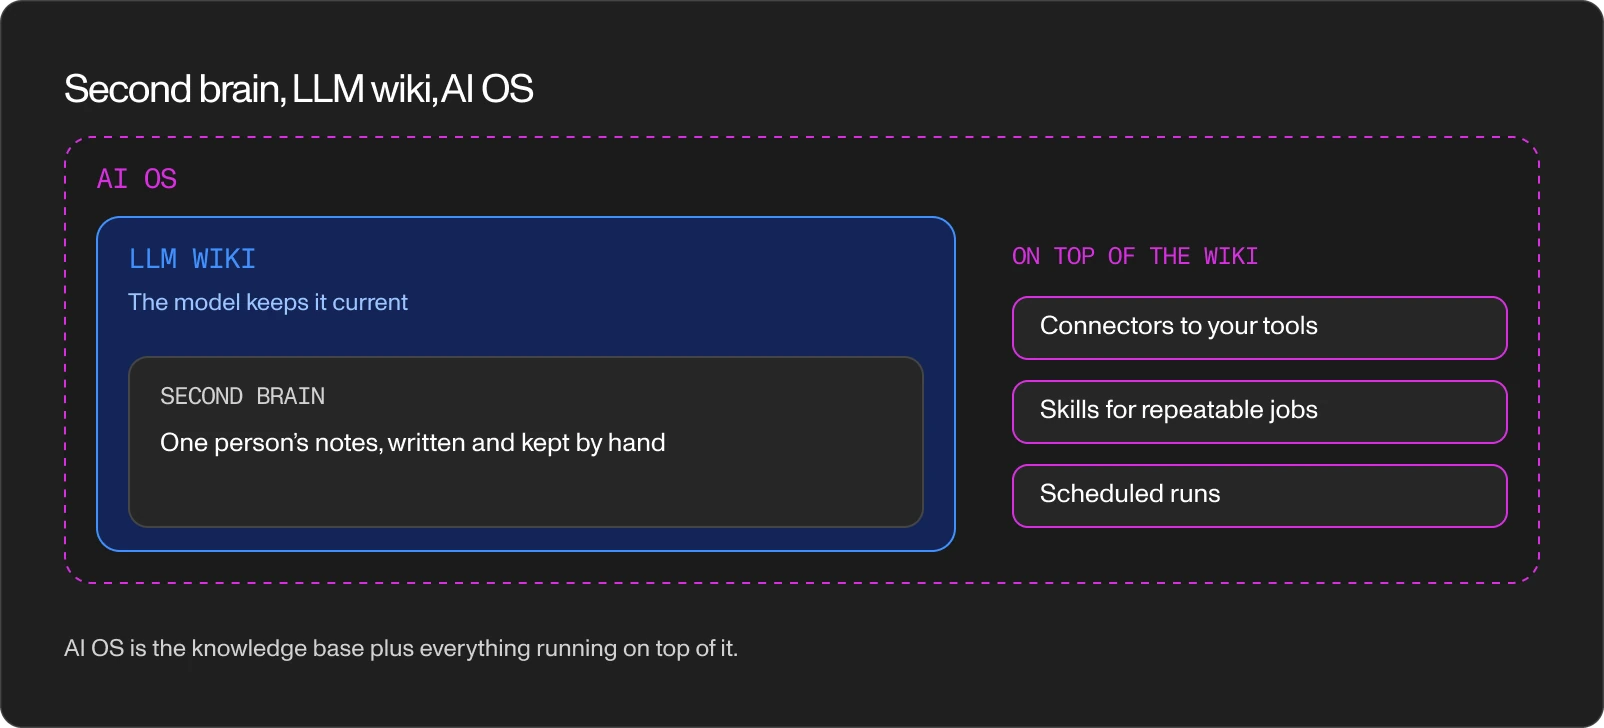
Preklapaju se i stoje jedan unutar drugoga. Second brain, doslovno drugi mozak, najstariji je od triju naziva i dolazi iz metode Tiaga Fortea za vođenje osobnih bilješki: to je spremište znanja jedne osobe izvan njezine glave, u izvornoj verziji organizirano ručno. LLM wiki je Karpathyjev naziv za način izgradnje takvog spremišta u kojem održavanje preuzima model, a njegova bilješka nigdje ne spominje ni second brain ni operativni sustav, te su oznake dodali ljudi koji su ideju preuzeli.
AI OS, skraćeno od AI operativni sustav, baza je znanja zajedno sa svime što radi povrh nje: konektorima prema alatima koje već koristite, skillovima za ponovljive poslove i zakazanim zadacima. Isti pojam izvan ove teme ima i druga značenja, od pravih operativnih sustava do softverskih paketa koji objedinjuju više alata, pa dobavljača pitajte na koje od njih misli. Najnovija je oznaka company brain, ili company second brain, za isti sustav u veličini tima, gdje dozvole, vlasništvo i pregled prestaju biti stvar izbora.
Treba li vam LLM wiki? Tri razine konteksta
Većini timova LLM wiki ne treba prvog dana, a razuman je redoslijed prvo uhodati dvije jednostavnije razine, jer se svaka nadograđuje na prethodnu.
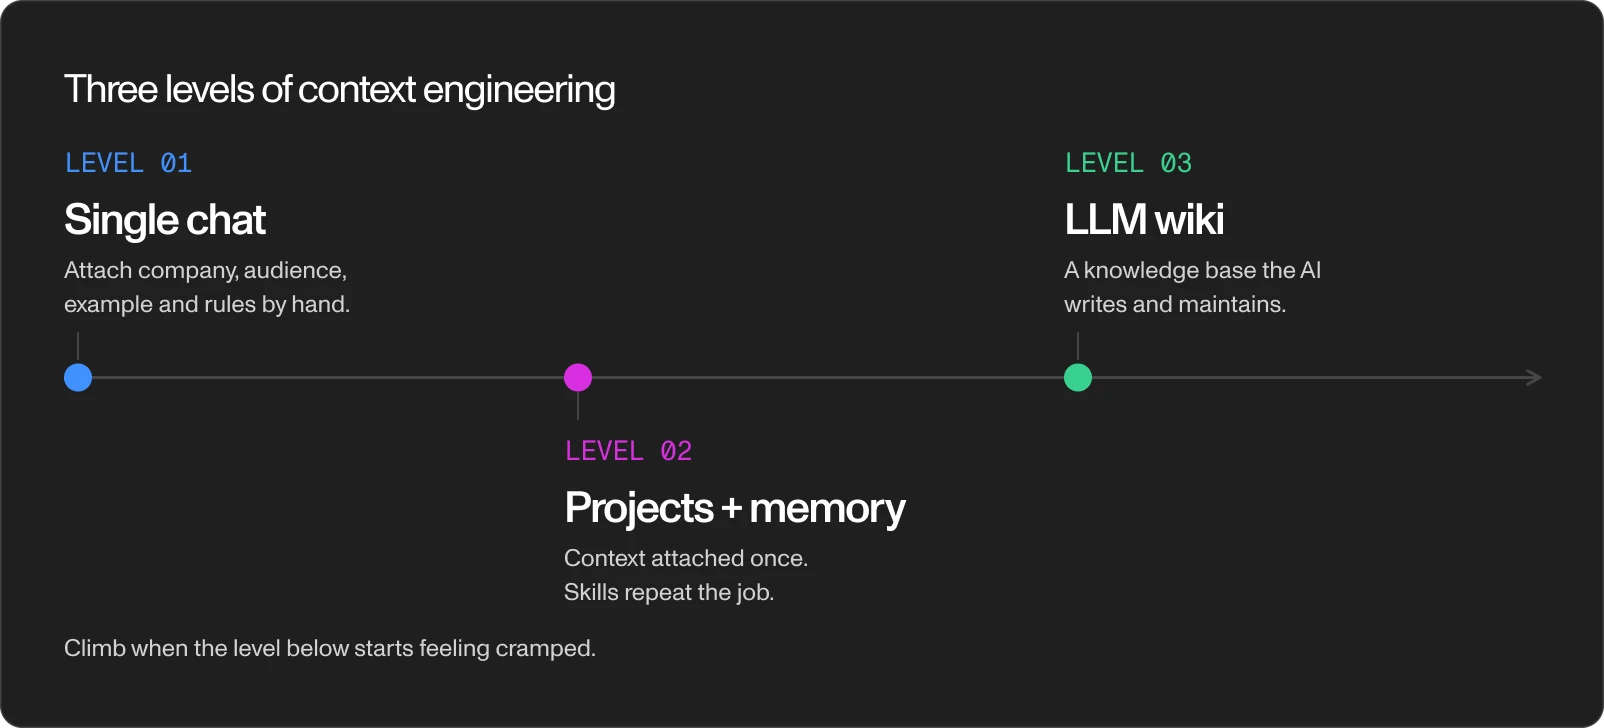
Prva razina je pojedinačni razgovor kojem ste priložili pravi materijal: tko ste, kome je rezultat namijenjen, primjer kako izgleda dobar rezultat i pravila kojih se rezultat mora držati. Druga razina je trajni radni prostor, kakav danas u nekom obliku nude i Claude, i ChatGPT, i Gemini. Projekti čuvaju vaše dokumente i stalne upute, memorija prenosi ispravke iz jednog razgovora u drugi (u Claudeu je to popis zapisa koje sami otvarate i uređujete), skillovi pakiraju ponovljiv posao poput tjednog izvještaja, a konektori povlače žive podatke iz Slacka, Gmaila ili vašeg alata za praćenje projekata. Jednoj osobi, ili jednom jasno omeđenom poslu, druga razina pokriva većinu onoga što je osobni second brain nekad obećavao.
Treća razina, LLM wiki, počinje se isplaćivati kad o istom znanju ovisi više ljudi i kad ono nadživi pojedini projekt, a to prepoznate po tome što ljudi istu pozadinu klijenta objašnjavaju u pet različitih razgovora, dok voditelji projekata listaju mjesece Slacka u potrazi za jednom odlukom. Timu od triju ljudi s urednim zajedničkim radnim prostorom on još ne treba, a nijedan wiki neće spasiti tim u kojem nitko ništa ne zapisuje. Ako tek razmišljate gdje umjetna inteligencija uopće ima mjesta u vašem poslovanju, prije svega ovoga krenite od strategije.
Kako postaviti LLM wiki?
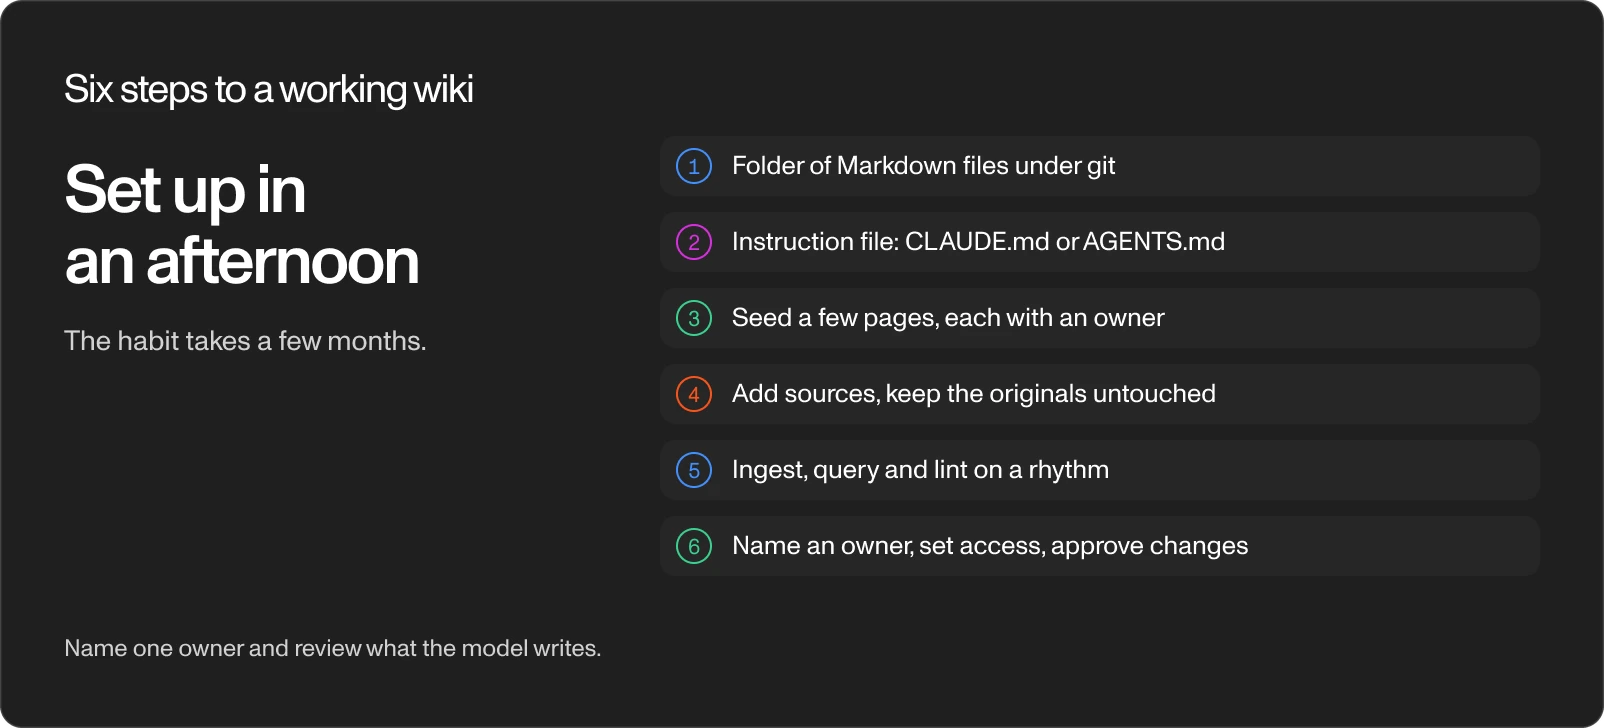
Strukturu postavite u jednom poslijepodnevu, a navici oko nje treba nekoliko mjeseci da se ustali:
- Napravite jednu mapu običnih markdown datoteka, povijest promjena čuvajte gitom ili verzioniranjem koje vaš dijeljeni disk već ima i smjestite je tamo odakle čita asistent svakog člana tima. Datoteke ostaju vaše i čitljive svakom modelu, što vrijedi sve više sa svakom promjenom alata.
- Napišite kratku datoteku s uputama, CLAUDE.md ili AGENTS.md, koja opisuje strukturu mape, kamo ide novo znanje i dva pravila: svaka tvrdnja ima poveznicu na svoj izvor, a model uz svaku promjenu ažurira indeks i dnevnik. Držite je na otprilike jednoj stranici, jer današnji modeli kratke upute slijede bolje nego duge.
- Postavite nekoliko početnih stranica od kojih svaka ima imenovanog vlasnika: čime se tvrtka bavi, tko su kupci, kakvim tonom komunicirate, usluge i cijene, aktivni projekti i dnevnik odluka.
- Dodajte izvore, a izvornike ostavite netaknute u zasebnoj mapi: transkripte sastanaka, e-mailove klijenata, ugovore, projektnu dokumentaciju. Prvih tjedana ubacujte ih ručno, a dotok automatizirajte konektorima tek kad se struktura prestane mijenjati.
- Tri operacije vrtite u ritmu: unos kad stigne novi izvor, upiti kao dio svakodnevnog posla, provjera jednom tjedno.
- Imenujte jednog vlasnika cijelog wikija, odlučite tko što vidi prije nego što se priključi druga osoba, povjerljive materijale klijenata držite u zasebnom dijelu s ograničenim pristupom i neka model promjene predlaže, a čovjek odobrava.
Što je promijenilo šest mjeseci prakse
Karpathy je obrazac napisao za jednu osobu i namjerno ga ostavio apstraktnim. Njegova bilješka, naime, kaže da pristup dobro radi u umjerenom opsegu, oko stotinu izvora i nekoliko stotina stranica, a timovima predlaže da ljudi pregledavaju izmjene. Oni koji su od travnja objavili svoja iskustva dolaze do iste šačice pravila, a sva se tiču povjerenja.
Svaka tvrdnja u wikiju pokazuje odakle je došla, a izvornik ostaje mjerodavan, što je najvažnije kod ugovora, cijena i datuma: wiki vam kaže u kojem je dokumentu klauzula, a samu klauzulu pročitate u izvorniku. Svaka činjenica sklona promjenama, poput cjenika ili popisa članova tima, stoji na jednoj stranici na koju sve ostale upućuju, pa se promjena unosi na jednom mjestu.
Ono što model napiše odobrava čovjek, uz automatske provjere kao potporu, jer pogrešan sažetak koji nitko ne uoči postaje temelj za stranice koje se na njega nadograđuju. Posljednje pravilo donosi veličina, jer nakon nekoliko stotina stranica indeks više nije dovoljan i pridružuje mu se pretraga, a tu granicu Karpathy navodi i u izvornoj bilješci. Veće tvrtke idu korak dalje i kombiniraju oba pristupa, pa jedan tim u Meti znanje koje njegovi stručnjaci koriste svaki dan drži u wikiju, rijetko potrebne dokumente poslužuje običnom pretragom, a izmjene odobrava stručnjak.
Održavanje pritom ne nestaje, samo se pisanje stranica pretvara u njihovu provjeru, zato planirajte kratak tjedni pregled, a wiki koji nitko ne provjerava smatrajte rizikom, jer će izgledati uredno i svejedno mjestimice biti netočan.
Kako koristimo svoj AI OS u Workspaceu
Prema gornjim definicijama, ono što koristimo u Workspaceu bliže je AI OS-u nego čistom wikiju: zajednička baza znanja sa skillovima i konektorima povrh nje. Najjasniji je primjer tjedni izvještaj klijentu. Za MedAdapt, mediteranski projekt prilagodbe klimatskim promjenama na kojem za PAP/RAC radimo početno istraživanje i UX, skill prikupi rasprave sa Slacka i e-mailove iz tog tjedna, složi izvještaj u našem stalnom formatu i pripremi e-mail kao skicu, koju voditelj projekta pročita, ispravi i pošalje.
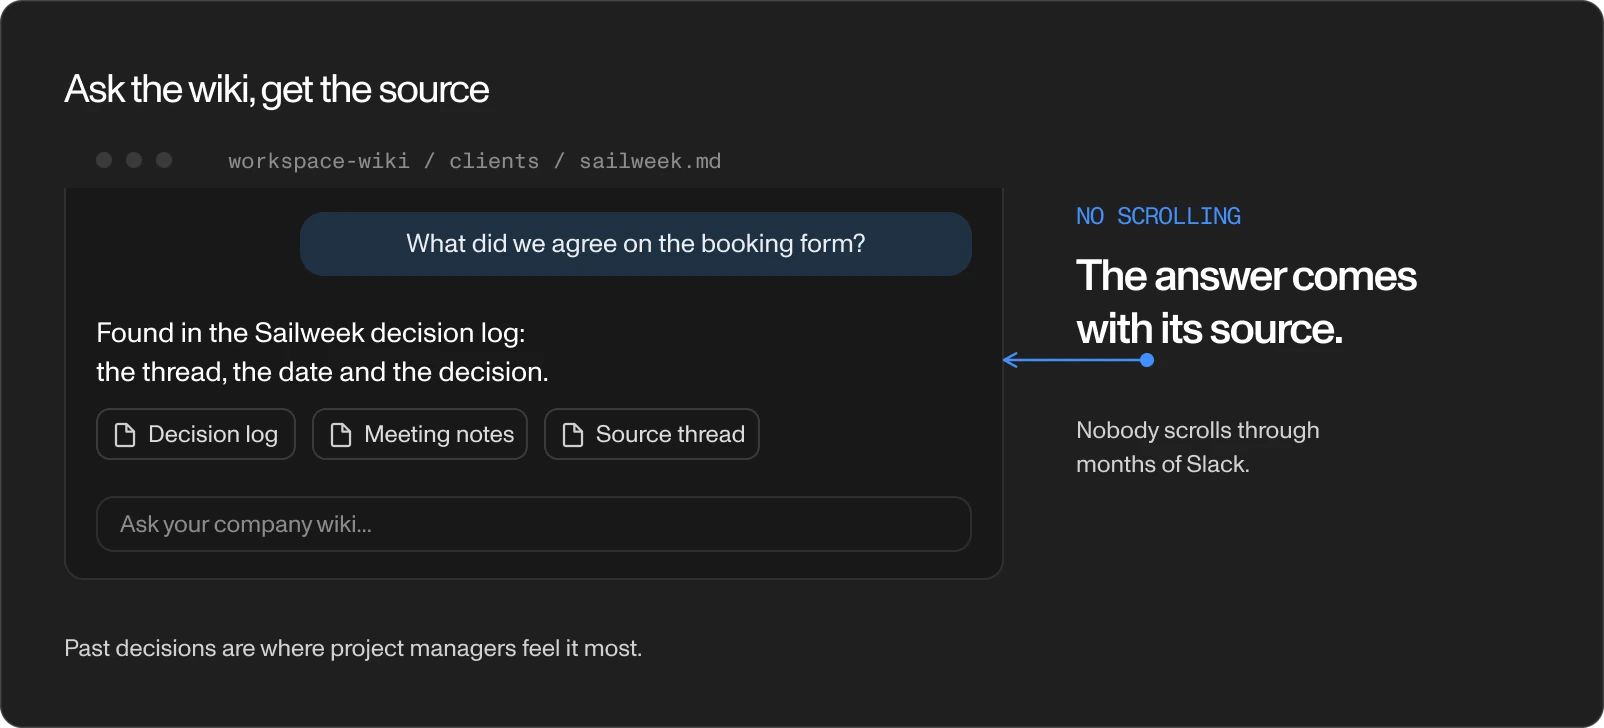
Razliku voditelji projekata najviše osjete kod prošlih odluka. Sa Sailweekom surađujemo od 2022., pa kad se pojavi pitanje što smo prije više mjeseci dogovorili oko njihova rezervacijskog obrasca, nitko više ne lista Slack, jer voditelj projekta pita asistenta i dobije raspravu, datum i odluku. Ugovori slijede pravilo iz prethodnog odjeljka: nacrti kreću iz biblioteke klauzula sastavljene od ugovora koje smo potpisali, a kad stigne zahtjev za promjenu, pogledamo što kaže potpisani ugovor i klauzulu pročitamo u izvorniku prije nego što odgovorimo.
Na istu se memoriju oslanjaju i procjene, jer svaka nova kreće od kataloga svih stavki koje smo procijenili od 2024., uspoređenih sa satima koje smo zabilježili na završenom poslu. Ta usporedba pokazuje koje vrste zadataka redovito podcjenjujemo, a taj se obrazac ne vidi iz perspektive jednog projekta. Isti sustav radi i istraživanje potencijalnih kupaca za Serwizz, naš CMMS za timove održavanja i servisa.
Isplati li se LLM wiki vašem timu?
LLM wiki se isplati graditi kad o istom znanju ovisi više ljudi i kad ono nadživi pojedine projekte, a koristan ostaje samo dok netko za njega odgovara i dok ga netko provjerava. Krenite s jednom mapom, nekoliko stranica s imenovanim vlasnicima, dnevnikom odluka i tjednim pregledom, a izvore dodajte kako se navika bude ustaljivala.
Ako želite da zajedno popišemo gdje znanje vašeg tima danas stoji i što spada u prvu verziju, javite nam se i dogovorite discovery razgovor.